以代码为媒介
他的图形是用代码写成的规则集,每一套都由系统的行为构建。这里的图也是规则集:一套决定数字落在哪里、有多粗重,一套决定注意力方块长多大,一套决定一次合并何时亮起。
用代码做设计Vibe Coding绘画与代码2026 年秋
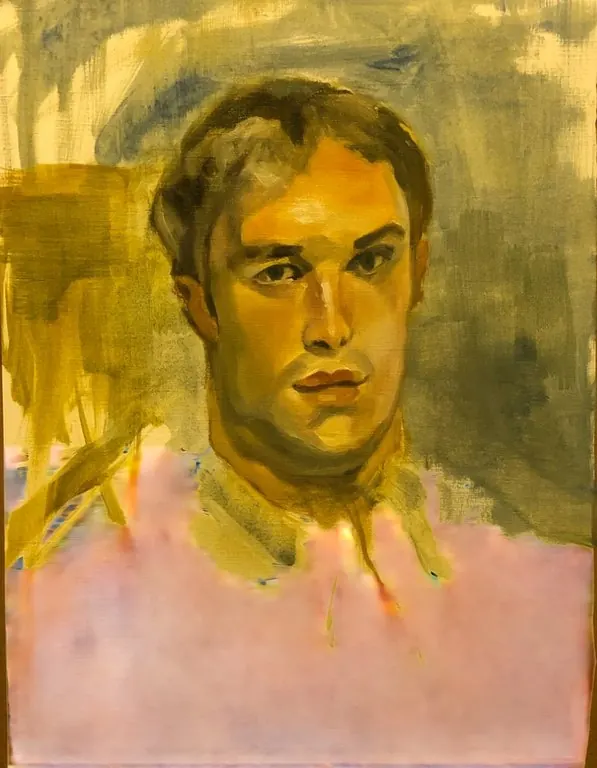
我把衬衫留成了空白的纸。一个模型从中读出了一件衬衫。代码用模型的数字把它画出来。
模型读到a painting of
a 90%man 1%the 1%
一幅肖像,以及两个开源模型在我的笔记本电脑上对它做的一切。图像描述模型读这幅画,把空白的纸叫作白衬衫;图像模型起草这件衬衫;代码再用图像模型运行时的数字,把它织在画上。下面的每一个词、数字和画面都来自这些运行。
绘画
这是我作为画家读同一幅画的方式。笔触顺着形体走,色调落在明度阶上,每种颜色都来自同一套色板。在这里,每一笔都重画成一行属于它自己的明度数字,0 最暗,9 最亮,用构成这幅画的八种颜色。线条从最暗的开始自己画出来,就像我起稿一幅肖像那样。
明度,0 最暗,9 最亮
我的色板,从颜料中取样的八种颜色
钴蓝,机器的颜色:在我的色板之外,在色轮上与色板里的赭石色相对。
解读
图像描述模型 BLIP 从“a painting of”开始,从一张排好序的列表里选下一个词。束搜索保留整体得分最高的句子,所以它选了 21% 的“in”,而不是 23% 的“with”,又选了 9% 的“looking”。接着它以 82% 的概率给一幅画安上了一台相机(camera)。在动笔之前,我换上了它自己的第二选择:5% 的“viewer”(观者)。
温度 0.6。 比它自己的概率更“冷”:它会贴近最初的选择,解读也就保持合理。 它抽出的 8 个解读中的三个;碰巧点了人名的,我都没放。
注视
它的视觉部分把画切成 576 个图块。对每个词,方块标出那些因注意力而提高了这个词概率的图块:用梯度加权的注意力,也是 BLIP 作者用来显示词语落在图中哪里的方法。“Man”找到了脸,“shirt”落在领口和下面的空白纸面上,而它说的“camera”,其实是他的眼睛。
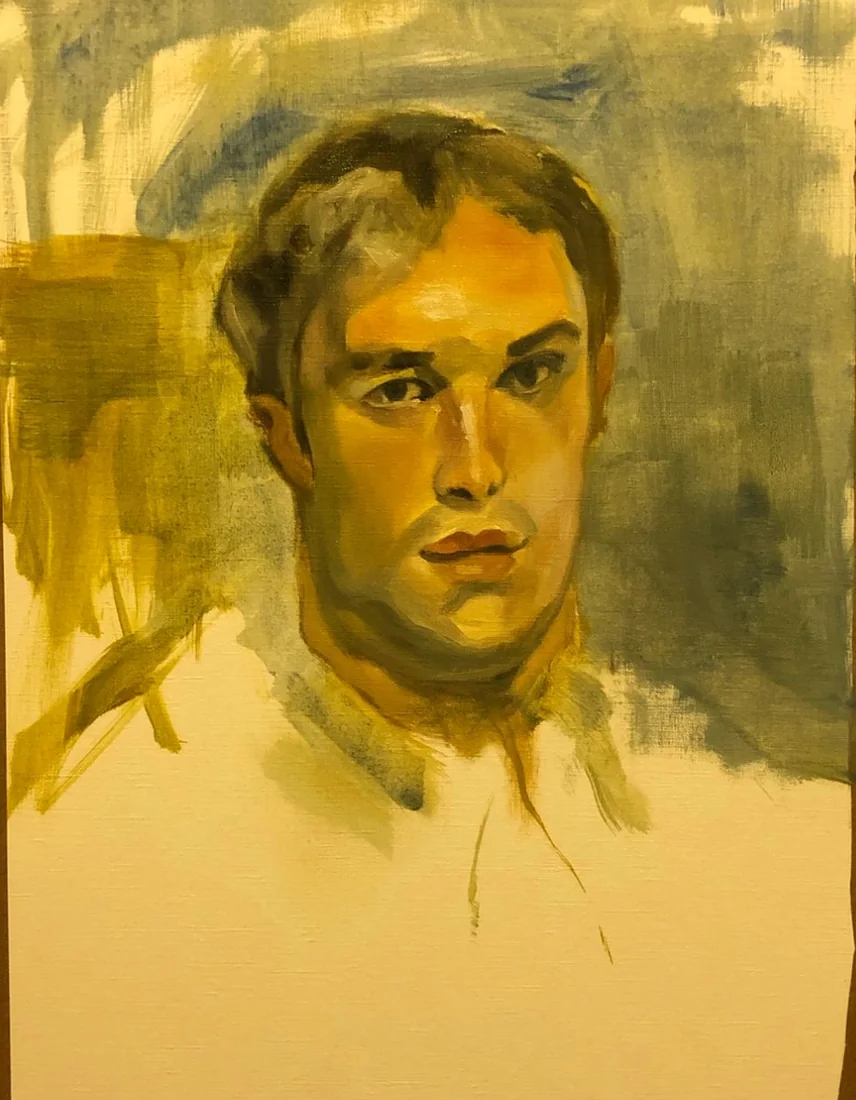
为了“shirt”,它看了领口和下面的空白纸面。我从没在那里画过衬衫。
576 个图块,24 × 24。方块的大小,表示这个图块的注意力把“shirt”的概率提高了多少;它给“{word}”的概率是 88%。
为什么是白衬衫
领口以下什么都没画,而在画室的灯光下,纸面拍出来是暖黄色。于是我每次只改一处,用同样的开头再问同一个模型。每组测试都列出给它的图、它读出了什么,以及在“a man in a”之后每个词的概率。
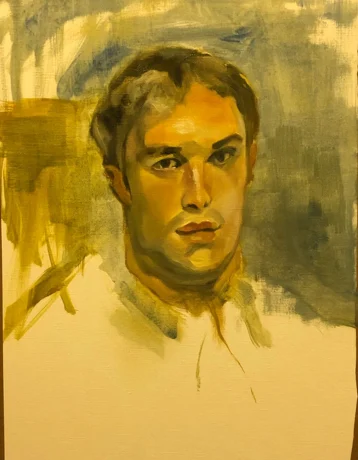 按我画的样子“a man in a white shirt looking at the camera”white 62%
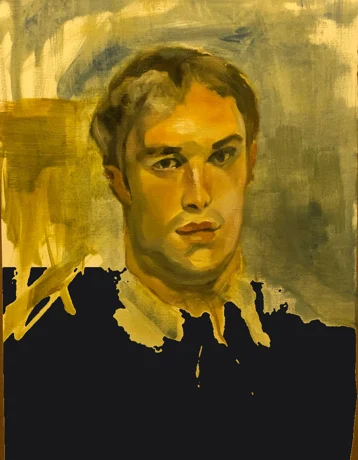 纸面填成黑色“a man in a black shirt and tie”black 53%white 1%
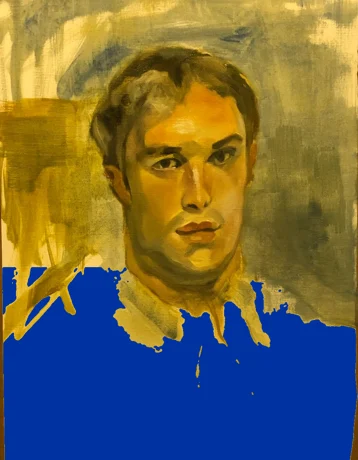 纸面填成蓝色“a man in a blue shirt looking at the camera”blue 85%white <1%
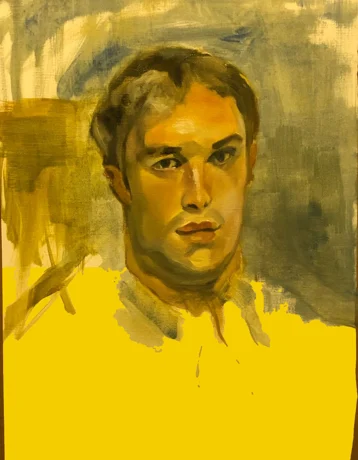 纸面填成黄色“a man in a yellow shirt looking at the camera”yellow 83%white 3%
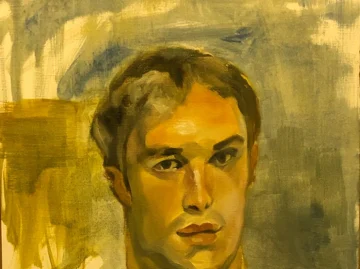 只留头部,裁掉纸面“a man in a suit and tie in front of a painting”suit 11%white 9%
 没有图,只有平涂的灰色“a man riding a surfboard on top of a wave”suit 11%white 5%
数字
在图像模型能用上这段解读之前,它自己的分词器要把每个词拆成从训练文本里学到的片段,再换成 ID。这 13 个数字,就是它看到的全部解读,也是衬衫将要织成的数字。
CLIP 的分词器从字母开始,不断合并它最早学到的那一对,直到“shirt”成为它认识的一个片段。名次是这一对在它从训练文本学到的 48,894 次合并中的位置;</w> 表示一个词的结尾。图像描述模型在自己的词表里把同一个词记作 3797:两个模型并不共用数字。
草稿
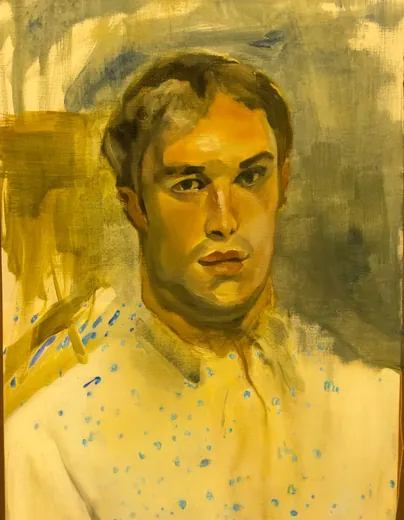
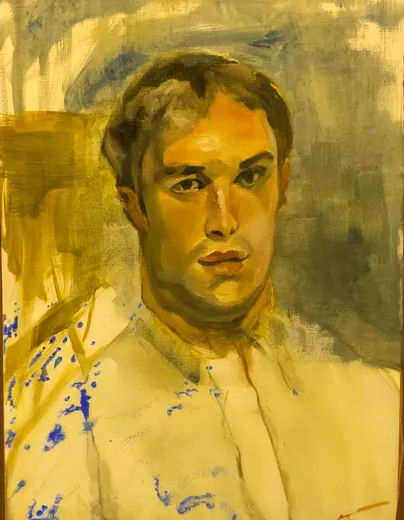
图像模型拿到这 13 个 ID,以及遮住空白纸面的画。在 29 步里,它不断猜测完成后的画面,先粗后细。我把它的草稿只当草稿:它决定褶皱和阴影的位置,但它的颜料一点也不会落到画布上。
提示词,来自它自己的解读:a man in a white shirt looking at the viewer
。每一帧都是它在那一步对完成画面的猜测。轮廓之外,画保持我留下的样子。
它做的每一份草稿,每个种子一份
代码
在我的画上,代码用这 13 个 ID 重画衬衫。草稿里越暗,数字就越粗重;模型在哪一步确定了某个位置,那里的数字就在哪一步落下。可以在我的画、模型的草稿和代码之间切换,并拖动查看每一步。
衬衫由图像模型收到的 13 个 token ID 织成。草稿里越暗,数字就越粗重;模型在哪一步确定了某个位置,那里的数字就在哪一步落下。我起稿的线条始终在最上层。
320308653932078653032015792523131253651815061
研究
在此之前,我研究过 AI 是如何被描绘的,也用代码画过模型内部的机制。下面的每一个来源,都是这幅画绘制方式中的一条规则。
他的图形是用代码写成的规则集,每一套都由系统的行为构建。这里的图也是规则集:一套决定数字落在哪里、有多粗重,一套决定注意力方块长多大,一套决定一次合并何时亮起。
用代码做设计AI 的图库图片总是机器人和发光的大脑,掩盖了系统在做什么、由谁制造。所以模型的部分从不伪装成颜料,而是以它自己的材料呈现,接缝清晰可见。
Better Images of AI无论是哪个词,原始注意力大多落在几个背景图块上,也就是视觉 Transformer 长出来的“寄存器”。用这个词概率的梯度来加权,只留下那些真正改变了这个词的注视。
Grad-CAM我最早是用为页面写的小模型来画这些机制的:一个在一页文本上训练的分词器、一个三元组采样器、基于规则的注意力头、一个线性去噪器。在这里,同样的四样东西,是真实模型在一幅画上的真实数字。
第一个研究在界面中
我设计 AI 产品。用模型来完成我自己的画,是我找到的最清楚的方式,去感受它的帮助应该止于哪里,以及怎样把它展示出来。
模型根据它的词行动,而不是根据我的意图。它给我的画安了一台相机;正因为它的解读和第二选择就摆在我面前,我才能在它画任何东西之前换上“viewer”。
代码图层放在我起稿的线条下面,从不盖在上面。AI 的贡献应该围绕作者已有的东西展开,而不是把它涂掉。
一种无法冒充颜料的材料,能准确显示机器在哪里工作过。出处被设计进画面本身,而不是画旁边的一张标签。
模型的草稿决定光影和形体,最后一层则是一个独立、可检查的选择。人们可以保留指引,拒绝颜料。
方法
笔触的方向来自颜料色调的结构张量,经过平滑,让它顺着笔触和形体走,而不是顺着画布的纹理。线条是等间距的流线,越暗越密;每个数字是它所在位置的明度,用八种颜色中最接近的一种,最暗的线最先画。
八种颜色,是对这幅画照片中上过颜料的区域聚类得到的,空白的纸不计在内,按从暗到亮排序。照片是在暖光下拍的,所以色板偏赭石色。
BLIP 图像描述(large),从“a painting of”开始,用五束的束搜索。我唯一的修改替换了它的最后一个词;候选词是修改后句子每一步的概率。其他解读是普通的温度采样,每个温度 8 个。
写出每个词的那一步对 24 × 24 个图块的交叉注意力,乘以它相对于这个词对数概率的正梯度,再对文本解码器的 12 个头和 12 层取平均。
同一个图像描述模型,同样的开头。把空白的纸,也就是衬衫所在的蒙版,平涂成一种颜色,上过颜料的部分和我起稿的线条保持原样;或者把头部以下裁掉;或者只给一张平涂的灰图。每个词的概率来自对“a painting of a man in a”的一次前向计算,解读则来自和上面相同的束搜索。
用 CLIP 那张含 48,894 次合并的合并表,重放它的字节对编码:从字母开始,不断合并它最早学到的那一对,直到没有可合并的为止。ID 就是图像模型收到的那些。
Stable Diffusion XL inpainting 0.1,约一百万像素,29 步 Euler,强度 0.99,引导系数 7,两个种子;每一步的预览用的是小型 SDXL 自编码器。某个位置的猜测在某一步之后始终与最终值相差不到 4%,就算在那一步确定。
画面像 ASCII 渲染那样变成字符(three.js 内置了一个),但每个字符都是一个数字:它所在位置从 0 到 9 的明度,按这幅画自己的明暗范围拉伸,用八种颜色中最接近的一种,越暗越大、越粗。它一块一块、一行一行地翻转,顺序就是视觉编码器排列 576 个图块的顺序。空白的纸留给衬衫。
空白纸面上的一张格子网,每隔一行错开半格。和纸一样亮的地方留空,越暗的地方数字越粗重,每个数字都在它的位置确定的那一步落下。
一切都运行在一台 M1 Pro 的 MacBook Pro 上,通过 PyTorch 使用 Apple GPU,模型是 Hugging Face 上的开源模型。这幅画从未离开过这台电脑。