未完成我把衬衫留成了空白的纸。一个模型从中读出了一件衬衫。 代码用模型的数字把它画出来。
一个反思性项目:我的一幅肖像,以及两个开源 AI 模型在我的笔记本电脑上对它做了什么。下面的每个词、每个数字和每一帧都来自这些运行。
- 角色
- 艺术家
创意技术专家 - 类型
- 反思性项目
- 模型
- BLIP、SDXL Inpainting
- 工具
- Claude Code、Python、PyTorch、React
- 运行环境
- 本地设备
- 渲染
- Canvas 2D 实时渲染
读作
“”
a 90%man 1%the 1%
寻找衬衫时看的地方
领口,以及下面的空白纸面
“white”的概率为 62%,接着“shirt”为 88%。我从没画过衬衫。
织自
320308653932078653032015792523131253651815061
图像模型运行时用的 13 个 token ID,以钴蓝显示。
概览
我画画,也设计 AI 产品。
这一次,模型帮我画完自己的画。
- 设计问题
- 在我自己的画里,模型的帮助应该止于哪里,它的那一部分又该怎样显露出来?
- 模型
- 图像描述模型 BLIP 读这幅画,Stable Diffusion XL 局部重绘起草衬衫。画作一直留在我的笔记本电脑上。
- 约束
- 模型的部分以它自己的材质呈现:钴蓝色的数字,覆盖在我未动过的颜料之上。
- 研究
- Justin Jay Wang 用代码做的图形,每幅图都是一套由系统行为构建的规则;Better Images of AI,关于如实呈现机器;Grad-CAM,关于模型看向哪里;以及 Model Studies,我的第一个研究,在那里我用玩具模型画了同样的机制。
绘画
在任何模型之前:笔触、明度和一套色板。
这是我作为画家读同一幅画的方式。每一笔都重画成一行属于它自己的明度数字,0 最暗,9 最亮,用构成这幅画的八种颜色,从最暗的画起,就像我起稿一幅肖像那样。
明度,0 最暗,9 最亮
我的色板,从颜料中取样的八种颜色
钴蓝,机器的颜色:在我的色板之外,在色轮上与色板里的赭石色相对。
解读
它一个词一个词地读这幅画。
BLIP 从“a painting of”开始,从一张排好序的列表里选下一个词。它选了 21% 的“in”,而不是 23% 的“with”,又选了 9% 的“looking”。接着它以 82% 的概率给一幅画安上了一台相机(camera)。在动笔之前,我换上了它自己的第二选择:5% 的“viewer”(观者)。
- a painting of给它的开头
- a
- a90%
- man1%
- the1%
- an1%
- young<1%
- man
- man60%
- young13%
- painting4%
- portrait3%
- close2%
- in
- with23%
- in21%
- is8%
- wearing7%
- looking5%
- a
- a67%
- white18%
- an1%
- front1%
- yellow1%
- white
- white62%
- shirt10%
- yellow3%
- polo2%
- baseball1%
- shirt
- shirt88%
- sweater1%
- polo1%
- collar1%
- t1%
- looking
- is13%
- and9%
- looking9%
- with8%
- looks7%
- at
- at21%
- to10%
- off7%
- into7%
- away5%
- the
- the68%
- something16%
- a5%
- camera2%
- his1%
- viewer我的修改
- camera82%
- viewer5%
- side1%
- right1%
- left<1%
它本可能写出的解读
- a young man wearing a white shirt and a brown hat
- a man with a baseball bat in his hands
- a man in a white shirt stares off into the distance
温度 0.6。 比它自己的概率更“冷”:它会贴近最初的选择,解读也就保持合理。 它抽出的 8 个解读中的三个;碰巧点了人名的,我都没放。
注视
它写下“shirt”时,看的是空白的纸。
它的视觉部分把画切成 576 个图块。对每个词,方块标出那些因注意力而提高了这个词概率的图块。“Man”找到了脸,而它说的“camera”,其实是他的眼睛。
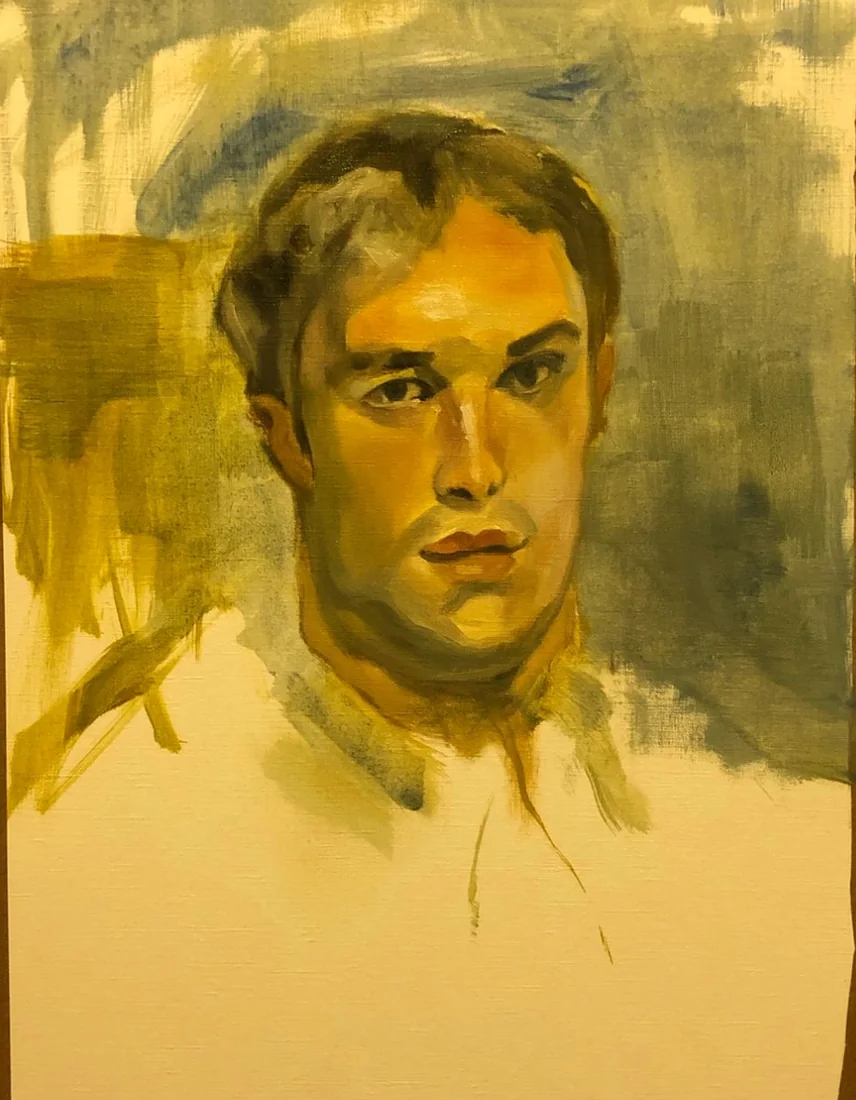
为了“shirt”,它看了领口和下面的空白纸面。我从没在那里画过衬衫。
576 个图块,24 × 24。方块的大小,表示这个图块的注意力把“shirt”的概率提高了多少;它给“{word}”的概率是 88%。
为什么是白衬衫
它用通常出现在那里的东西填满空白的纸,用的是纸的颜色。
为了弄清原因,我每次只改一处,再用同样的开头去问同一个模型。每次测试都显示它看到的画面、它读出的内容,以及“a man in a”之后每个词的可能性。
 按我画的样子“a man in a white shirt looking at the camera”white 62%
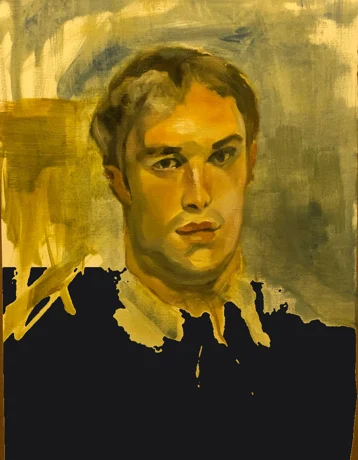 纸面填成黑色“a man in a black shirt and tie”black 53%white 1%
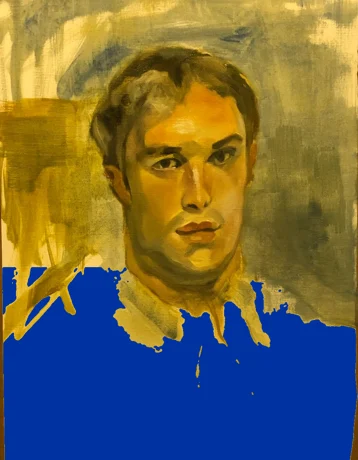 纸面填成蓝色“a man in a blue shirt looking at the camera”blue 85%white <1%
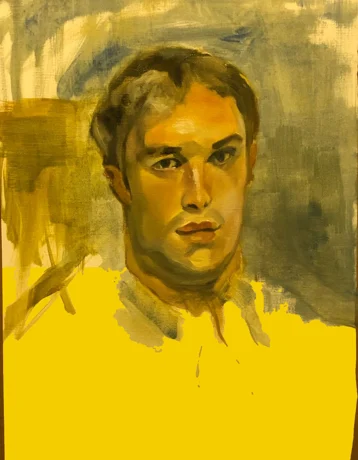 纸面填成黄色“a man in a yellow shirt looking at the camera”yellow 83%white 3%
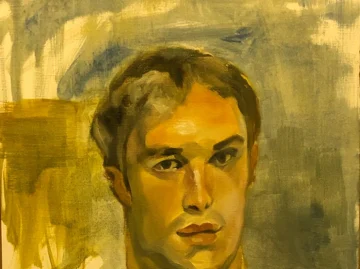 只留头部,裁掉纸面“a man in a suit and tie in front of a painting”suit 11%white 9%
 没有图,只有平涂的灰色“a man riding a surfboard on top of a wave”suit 11%white 5%
- 颜色来自纸面。
- 把纸面填成黑、蓝或黄,衬衫就变成黑、蓝或黄:53%、85% 和 83%。我的纸拍出来是暖奶油色,但作为画里最浅的东西,它被读成了白色,62% 对黄色的 3%。
- 脸的下面,它预期是衣服。
- 无论纸面是什么颜色,后面那个词都是“shirt”,51% 到 88%。把纸面裁掉,它还是给他穿上了衣服:西装和领带。
- 不只是词语的作用。
- 没有图时,“a man in a”后面接“white”的概率只有 5%。那 62% 来自看那张纸。
- 它没有表示“未完成”的词。
- 从“an unfinished painting of”开始,它仍然写出“a young man in a white shirt”。它读不出空白纸面就是空白。
所以这个工具会在动笔之前,先显示它的读法,以及它差点选中的词。
数字
图像模型拿到的是数字,不是词。
它自己的分词器把每个词拆成从训练文本里学到的片段,再换成 ID。这 13 个数字,就是它看到的全部解读,也是衬衫将要织成的数字。
- 字母shirt</w>
- 第 41 次合并shirt</w>
- 第 71 次合并shirt</w>
- 第 1,445 次合并shirt</w>
- 第 2,012 次合并shirt</w>
- Token ID2523
CLIP 的分词器从字母开始,不断合并它最早学到的那一对,直到“shirt”成为它认识的一个片段。名次是这一对在它从训练文本学到的 48,894 次合并中的位置;</w> 表示一个词的结尾。图像描述模型在自己的词表里把同一个词记作 3797:两个模型并不共用数字。
草稿
它从噪声里起草衬衫,先画大形。
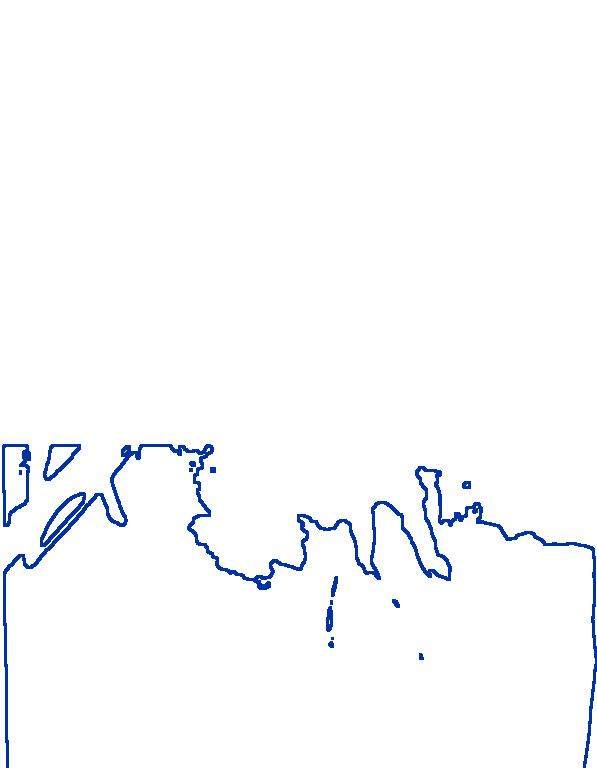
它拿到这 13 个 ID,以及遮住空白纸面的画。在 29 步里,它不断猜测完成后的画面,先粗后细。我把它的草稿只当草稿:它决定褶皱和阴影的位置,但它的颜料一点也不会落到画布上。
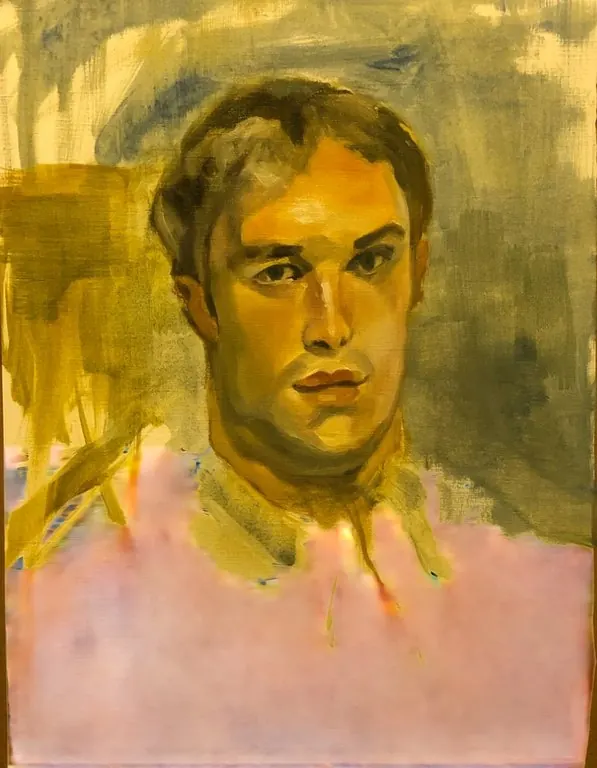
提示词,来自它自己的解读:a man in a white shirt looking at the viewer
。每一帧都是它在那一步对完成画面的猜测。轮廓之外,画保持我留下的样子。
它做的每一份草稿,每个种子一份
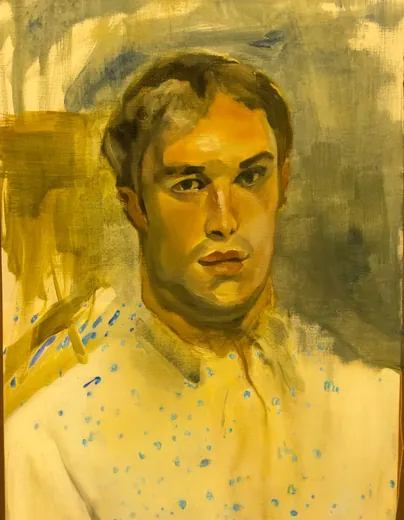
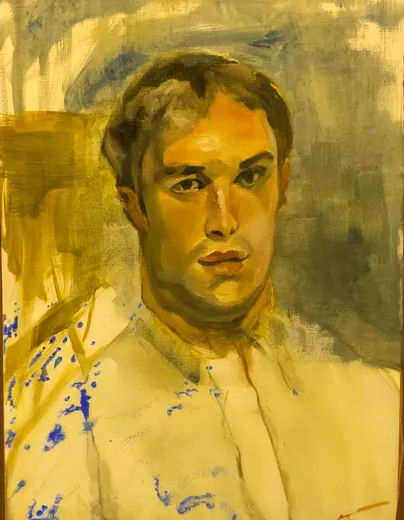
代码
代码用这些数字织出衬衫。
在我的画、模型的草稿和代码之间切换,并拖动查看每一步。
衬衫由图像模型收到的 13 个 token ID 织成。草稿里越暗,数字就越粗重;模型在哪一步确定了某个位置,那里的数字就在哪一步落下。我起稿的线条始终在最上层。
320308653932078653032015792523131253651815061
反思
它如何改变了我设计 AI 工具的方式。
在自己的画上做这件事,让这些问题变得很容易感受到,我在产品工作里也不断回到它们。
每幅图如何一步步做出来,以及所有来源,都在完整版里。